== 和 ===
==:比较值,类型不同的时候,先进行类型转换,再比较值;1 == “1” true
===:比较类型和值,不做类型转换,类型不同就是不等;1 === “1” false
Object.is(value1, value2)
Object.is()是在 ES6 中定义的一个新方法,它与 ‘===’ 相比,特别针对-0、+0、NaN 做了处理。
+0 === -0; // true
NaN === NaN; // false
Object.is(+0, -0); // false
Object.is(NaN, NaN); // true
Object.is(NaN, 0 / 0); // true
== 比较时的隐式转换
== 比较其实就是数值的比较。如果是基本类型比较,会转化成数字去比较。引用类型,会使用地址去比较。基本类型和引用类型比较,都转化成数字去比较。
基本数据类型比较,比较值
- Boolean 和其他任何类型比较,Boolean 被转换为 Number 类型。Number(false) 是 0,Number(true) 是 1
- String 和 Number 比较,先将 String 转换为 Number 类型( parseInt 或者 Number() )。除了数字型 string 可以转成 number,其他都是 NaN。Number(‘’) 是 0。
- null == undefined 比较结果是 true,除此之外,null、undefined 和其他任何结果的比较值都为 false。
两个引用类型比较,引用地址不一样,直接 false。
基本类型和引用类型做比较时,引用类型会依照 ToPrimitive 规则转换为基本类型(依次去调用对象的 valueOf,toString 方法)。
- 引用类型先调用 valueOf(),如果是基本类型,直接返回
- 不是基本类型,再调用 toString
-
String 再转 Number,最终用 Number 比较。
[].valueOf().toString() === '' // 转 number 是 0
{}.valueOf().toString() === '[object Object]' // 转 number 是 NaN
[] == false // true
{} == false // false
一元加运算符 +
一元加对其操作数会执行强制数字转换。意味着调用它的 valueOf()。然而,如果对象没有一个自定义的 valueOf() 方法,基本的实现将会导致 valueOf() 被忽略,转而使用 toString() 的返回值。
+new Date(); // current timestamp;
+{}; // NaN
+[]; // 0
+[1]; // 1
+[1, 2]; // NaN
+new Set([1]); // NaN
+{ valueOf: () => 42 }; // 42
让 a==1 && a==2 && a==3 成立
a 如果是基础类型,不可能成立,a 只能是对象,重写对象的 valueOf 方法
var a = {
  value: 0,
  valueOf() {
    this.value++;
    return this.value;
  },
};
与或非优先级运算
与或非混合时,非>与>或。
(true && !false) || false; // true
false || (!false && false); // false
&& 和 || 的短路运算
-
&&的短路运算:左边能转成 false,无条件返回左边式子的值。反之无条件返回右边式子的值false && 1; // 输出false true && 1; // 输出1 -
||的短路运算:若左边能转成 true,无条件返回左边式子的值。反之无条件返回右边式子的值false || 1; // 输出1 true || 1; // 输出true
按位与 &, 按位或 |, 按位异或 ^,左移 «,右移 »
将十进制转化为二进制,再进行与或移位运算
1、按位与 &,如果对应的位都为 1,那么结果就是 1, 如果任意一个位是 0 则结果就是 0
// 1的二进制表示为: 00000000 00000000 00000000 00000001
// 3的二进制表示为: 00000000 00000000 00000000 00000011
// 按位与 &
// 结果为:        00000000 00000000 00000000 00000001
console.log(1 & 3); // 1
2、按位或 |,对应的位中任一个数为 1 那么结果就是 1
// 1的二进制表示为: 00000000 00000000 00000000 00000001
// 3的二进制表示为: 00000000 00000000 00000000 00000011
// 按位或 |
// 结果为:        00000000 00000000 00000000 00000011
console.log(1 | 3); // 3
3、按位异或 ^,对应两个位有且仅有一个 1 时结果为 1,其他都是 0
// 1的二进制表示为: 00000000 00000000 00000000 00000001
// 3的二进制表示为: 00000000 00000000 00000000 00000011
// 按位异或 ^
// 结果为:        00000000 00000000 00000000 00000010
console.log(1 ^ 3); // 2
4、左移 «,向左移动对应的位数,高位移出,低位的空位补零。相当于算术运算的乘法,乘以 2 的 n 次方
// 1的二进制表示为: 00000000 00000000 00000000 00000001
// 左移一位
// 结果为:        00000000 00000000 00000000 00000010
console.log(1 << 1); // 2,     1左移一位,相当于 1 * 2¹
5、右移 »,除了最左边符号位,其他位向右移动对应的位数,被移出的位被丢弃。相当于算术运算的除法,除以 2 的 n 次方并取整
// 64的二进制表示为: 00000000 00000000 00000000 01000000
// 右移5位
// 结果为:         00000000 00000000 00000000 00000010
console.log(64 >> 5); // 2,    64左移5位,相当于 64 / 2⁵
十进制转二进制
转二进制 toString(2)
const number = 100;
number.toString(2);
parseInt(string, radix)
解析一个字符串并返回十进制整数。
第一个参数是要解析的字符串,第二个参数代表字符串的进制,是 2-36 之间的整数,例如指定 16 表示被解析值是十六进制数。那对于基数是 0,1,37,或者 null,undefined 怎么处理呢?
如果超出 2-36 这个范围,将返回 NaN。但是指定 0 或未指定时,基数将会根据字符串的值进行推算。
- 如果输入的 string 以 “0x”或 “0X” 开头,那么 radix 被假定为 16,字符串的其余部分被当做十六进制数去解析。
- 如果输入的 string 以 “0” 开头, radix 被假定为 10(十进制)。
- 如果输入的 string 以任何其他值开头, radix 是 10 (十进制)。
如果第一个参数不符合基数所指定的进制,parseInt 也会返回 NaN。
["1", "2", "3"].map(parseInt); // 输出

// 相当于执行了三次parseInt
parseInt("1", 0); // 1,因为基数是0或者undefined,根据字符串自动推算,不是16进制,所以就是10进制,输出1
parseInt("2", 1); // NaN,因为没有基数是 1
parseInt("3", 2); // NaN,因为字符串 '3' 不符合二进制数的表示,因此 parseInt 无法将其解析为有效的数字
如果我们需要返回 1,2,3 需要怎么办?
function parseIntFun(item) {
  return parseInt(item, 10);
}
["1", "2", "3"].map(parseIntFun);
number 的位数,最大/小值,最大/小安全整数
JS 的基础类型 Number,遵循 IEEE 754 规范,采用双精度存储,占用 64 bit。
其中 0 到 51 存储数字(占 52 位),52 到 62 存储指数(占 11 位),63 位存储符号,如图:
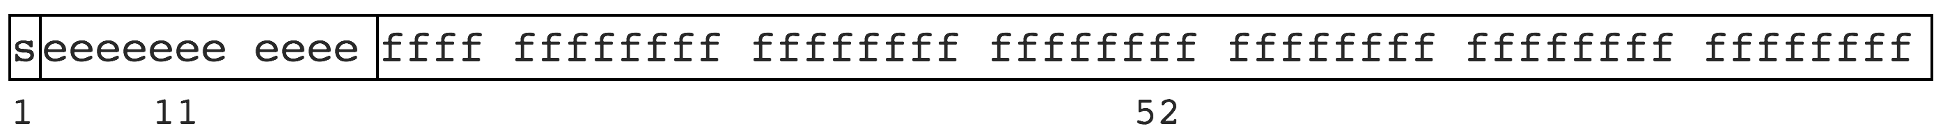
Number 提供了最大/小值,最大/小安全整数的常量:
- Number.MAX_VALUE,
- Number.MIN_VALUE,
- Number.MAX_SAFE_INTEGER,
- Number.MIN_SAFE_INTEGER
6 种基本数据类型和 3 种引用类型
number, boolean, string, null, undefined, Symbol
Object, Array, Function
javascript 自带的数据结构
Object, Array, Set, Map, WeakSet, WeakMap
js 内置对象
基本对象:数据类型对应的对象
- Object
- Function
- Array
- Number
- String
- Boolean
ES6 新增对象:
- Symbol
- Set & WeakSet
- Map & WeakMap
- Proxy
- Reflect
- Promise
其他对象:
- Error
- Date
- Math
- RegExp
- JSON
基本数据类型和引用类型存储在哪里
基本数据类型:变量标识符和变量的值存放于栈内存。占用固定大小的空间。
引用类型:变量标识符和对象的指针存放于栈,具体的对象存放于堆。
一个 string,他不定长,放在栈中是怎么处理的
基本数据类型不一定是直接存在栈中的。
- 字符串: 存在堆里,栈中为引用地址,如果存在相同字符串,则引用地址相同。
- 数字: 小整数(-2³¹ 到 2³¹-1(2³¹≈2*10⁹)的整数)存在栈中,其他类型存在堆中,如小数。
- 其他类型:引擎初始化时分配唯一地址,栈中的变量存的是唯一的引用。
null 和 undefined 有什么区别
null 表示空对象
undefined 表示未初始化的变量
Object 和 Map 有什么区别
- Object key 的类型只能是字符串,数字或者 Symbol;而 Map 可以是任何类型。
- Map 中的元素会保持其插入时的顺序;而 Object 则不会完全保持插入时的顺序。
- Object 的 key 顺序:
- 先 number 类型,后字符串类型。
- key 是整数或者整数类型的字符串,那么会按照从小到大的排序。
- 其它类型字符串,控制台展示的时候,按照 ASC 码升序排序,如果用 Object.keys()获取,按照实际创建顺序排序。
- Map 是可迭代对象,所以其中的键值对是可以通过 for of 循环或 .foreach() 方法来迭代的;而普通的对象键值对则默认是不可迭代的,只能通过 for in 循环来访问。
对象作为 key
一个对象作为 key,会将对象 toString(),转成[object Object],第二个 O 大写
var a = { name: "Sam" };
var b = { name: "Tom" };
var o = {};
o[a] = 1;
o[b] = 2;
console.log(o[a]); // 2
函数柯里化
柯里化是指把接收多个参数的函数变换成接收单一参数的函数,嵌套返回直到所有参数都被使用并返回最终结果。
更简单地说,柯里化是一个函数变换的过程,是将函数从调用方式:f(a,b,c)变换成调用方式:f(a)(b)(c)的过程。柯里化不会调用函数,它只是对函数进行转换。
function.length 和 arguments.length 的区别
function.length 是形参的个数,arguments.length 是实参的个数
箭头函数中没有 arguments 和 this。
const sum = function (a, b, c) {
  console.log(arguments.length);
};
console.log(sum.length); // 3
sum(1, 2); // 2
sum(1, 2, 3, 4); // 4
函数内部 arguments 变量有哪些特性,有哪些属性,如何将它转换为数组
arguments 对象是函数接受的参数所组成的数组,所有非箭头函数中都可用的局部变量。可以使用 arguments[i] 引用函数的参数,也可以修改函数参数。
arguments.callee指向当前执行的函数,也就是函数本身。arguments.length指向传递给当前函数的参数数量。
转换为数组:
var arr = [...arguments];Array.prototype.slice.call(arguments);Array.from(arguments)
函数的参数是按照什么方式传递的
传递参数就是变量复制的过程,将实参的值赋值给形参。
其实都是按值传递的。只不过有的值是基本类型,有的值是内存地址。
证明不是按引用传递
var person = { name: "MJ" };
function changeName(obj) {
  obj.name = "test";
  obj = new Object();
  obj.name = "EP";
}
changeName(person);
console.log(person.name); // 输出test
说明形参 obj 和实参 person 是两个东西,只不过值相同,都是同一个内存地址,都指向了同一个对象。
如果是按引用传递,那他两个应该是同一个东西,修改 obj=new Object()之后,person 也应该是这个新的 object。
箭头函数可以作为构造函数吗
不可以。
普通函数在运行时才会确定 this 的指向。箭头函数则是在函数定义的时候就确定了 this 的指向,此时的 this 指向外层的作用域。所以不可以用来做构造函数,因为如果做构造函数,生成的实例的 this 不是指向实例,而是指向箭头函数的上下文,这是不对的。
Object.defineProperty(obj, prop, descriptor)
在一个对象 obj 上定义一个新属性 prop,或者修改一个对象的现有属性,并返回这个对象。
descriptor 属性描述符有两种主要形式:数据描述符和存取描述符。描述符必须是这两种形式之一,不能同时是两者。
存取描述符
- get:默认为 undefined。
- set:默认为 undefined
数据描述符
- writable:默认为 false。为 true 时,value 才能被赋值运算符改变。
- value:默认是 undefined。
数据描述符和存取描述符均具有以下可选键值
- configurable:默认为 false。为 true 时,该属性描述符才能够被再次 defineProperty,或者删除。
- enumerable:默认为 false。为 true 时,该属性才能够出现在对象的枚举属性中。
Object.prototype.hasOwnProperty(),Object.getOwnPropertyNames(),in
Object.prototype.hasOwnProperty:它会检查属性是否存在于对象本身,而不是继承的原型链上。
Object.getOwnPropertyNames:用于获取对象自身的所有属性名称,包括可枚举和不可枚举属性。不会去检查原型链上的属性。
in:操作符用于检查对象的属性是否存在于对象或其原型链中。
instanceof, typeof, Object.prototype.toString.call()
instanceof 用于判断某个对象是否是某个构造函数的实例。即检测构造函数的 prototype 属性是否出现在某个实例对象的原型链上。所以主要是用来检测对象和数组,无法准确判断 Function 和基本数据类型
console.log([] instanceof Array); // true
console.log({} instanceof Object); // true
console.log(/\d/ instanceof RegExp); // true

console.log(function () {} instanceof Object); // true
console.log(function () {} instanceof Function); // true

console.log("" instanceof String); // false
console.log(1 instanceof Number); // false
console.log(true instanceof Boolean); // false
typeof 可以用于判断基本数据类型和函数,判断不出来 null, 对象,数组。输出的是小写的。
typeof 1; // "number"
typeof "1"; // "string"
typeof true; //"boolean"
typeof undefined; // "undefined"
let s = Symbol();
typeof s; // "symbol"

typeof function () {}; // "function"
typeof Object; // "function"
typeof Array; // "function"
typeof Function; // "function"

typeof null; // "object"
typeof {}; // "object"
typeof []; // "object"
typeof new Boolean(false); // "object"
typeof new Date(); // "object"
Object.prototype.toString.call(),可以精确判断所有类型,前面是小写的 object,后面是具体的类型
Object.prototype.toString.call(1); // "[object Number]"
Object.prototype.toString.call("1"); // "[object String]"
Object.prototype.toString.call(true); // "[object Boolean]"
Object.prototype.toString.call(new Boolean(false)); // "[object Boolean]"
Object.prototype.toString.call(null); // "[object Null]"
Object.prototype.toString.call(undefined); // "[object Undefined]"
Object.prototype.toString.call([]); // "[object Array]"
Object.prototype.toString.call({}); // "[object Object]"
Object.prototype.toString.call(Function); // "[object Function]"
Object.prototype.toString.call(Array); // "[object Function]"
Object.prototype.toString.call(Object); // "[object Function]"
call,apply,bind 区别
第一个参数都是要绑定的 this 指向。
apply 的第二个参数是一个参数数组,call 和 bind 的第二个及之后的参数作为函数实参按顺序传入。
bind 不会立即调用,其他两个会立即调用。
Object.assign()、ES6 的扩展运算符是深拷贝吗
扩展运算符和 Object.assign()都是只复制最外面一层,所以根属性是深拷贝,里面的对象依然是浅拷贝
实现深拷贝
如果是对象,循环每一个 key,判断每一项
- 如果是循环引用,直接复制
- 否则直接递归该元素
如果是数组,递归每一个元素。
如果是函数,函数复制。用 new Function('return' + fun.toString())()。
如果是值类型,直接复制。
节流(throttle),防抖(debounce)
节流:频繁操作的时候,如果超过了设定的时间,就执行一次处理函数。周期性的执行。核心点是两个时间点。
防抖:频繁操作的时候,先把 timer 清除,重新 setTimeout 计时并赋值给 timer。setTimeout 的时间到了才执行一次。核心点是一个定时器。
函数防抖是某一段时间内只执行一次,而函数节流是间隔时间执行。
map、forEach、for in、for of、Object.keys、in
-
map 遍历数组,并返回一个新的数组,新数组元素为原来的数组的每个元素调用 func 的结果,不影响原数组
arr.map((value, index, arr) => { return ... }) -
forEach 遍历数组,不影响原数组
arr.forEach((value, index, arr) => { ... }) -
for in 遍历对象的 key,因为 key 排序的问题,无法保证遍历顺序。
for (var prop in obj) { ... } -
for of ES6 引入,用来遍历任何有 Iterator 接口的数据结构,如数组, Set, Map, String, Arguments 等
for (var value of arr) { ... } -
Object.keys 也是循环对象的 key,返回一个数组
-
in 操作符用来判断某个 key 是否在对象中。
js 跳出循环,break, continue, return
-
for 循环,for of 循环,while 循环,for in 循环。都是 break 跳出循环,continue 下一次循环
-
map, forEach 等循环,不能跳出循环,如果想跳出,只能主动抛出一个异常。throw new Error()
-
return 一般用来作为函数的返回值,不能单独用在循环中。写在某函数的循环中,相当于结束了函数,所以也结束了循环。forEach 中的 return 只是用于当前循环回调函数的退出,并不影响整个 forEach 循环的继续执行。
[1, 2, 3, 4].forEach((item) => {
  console.log(item);
  if (item === 2) {
    return;
  }
  console.log("test");
});
// 1
// test
// 2
// 3
// test
// 4
// test
字符串操作
str.charAt()返回在指定位置的字符str.concat(str2)连接字符串str.indexOf(str2)返回某个指定的字符串值在字符串中首次出现的位置str.lastIndexOf(str2)返回一个指定的字符串在字符串中最后出现的位置,从后向前搜索str.match(regexp)在字符串内找到一个或多个正则表达式的匹配,返回一个数组str.replace(regexp/substr, str2)在字符串中用一些字符替换另一些字符,或替换一个与正则表达式匹配的子串str.search(regexp/substr)检索字符串中指定的子字符串,或检索与正则表达式相匹配的子字符串,返回相匹配的子串的起始位置str.split(),将字符串变为数组,以某符号分割。str.toLowerCase()把字符串转换为小写。str.toUpperCase()把字符串转换为大写。str.localeCompare(str2)如果 str 存在于 str2 之前则为负数; 如果 str 存在于 str2 之后则为正数; 相等的时候返回 0
字符串截取
slice 和 substring 都使用索引来指定截取的位置,而 substr 使用起始索引和长度。
str.slice(start,end)返回一个新的字符串。从 start 开始(包括 start)到 end 结束(不包括 end)。str.substring(start, end)返回一个新的字符串, 从 start 开始(包括 start)到 end 结束(不包括 end)。str.substr(start, length)抽取从 start 下标开始的指定数目的字符。
ES6 新增字符串操作
str.includes(str)返回布尔值,表示是否找到了参数字符串。str.startsWith(str)返回布尔值,表示参数字符串是否在原字符串的头部。str.endsWith(str)返回布尔值,表示参数字符串是否在原字符串的尾部。str.repeat(n)方法返回一个新字符串,表示将原字符串重复 n 次。n 为 0 则返回空串str.padStart(n, str),str.padEnd(n, str)字符串补全长度。如果某个字符串不够指定长度,会在头部或尾部补全。trimStart()和trimEnd()与 trim() 一致,trimStart() 消除字符串头部的空格,trimEnd() 消除尾部的空格。str.replaceAll(regexp/substr, str2)替换所有
数组操作
arr.push(a, b, c...)从后面添加一个或多个元素,返回值为添加完后的数组的长度arr.pop()从后面删除一个元素,返回值是删除的元素arr.shift()从前面删除一个元素,返回值是删除的元素arr.unshift(a, b, c...)从前面添加一个或多个元素, 返回值是添加完后的数组的长度。第一个参数将成为数组的新元素 0,如果还有第二个参数,它将成为新的元素 1arr.slice(start, end)截取数组,返回 start 到 end 的数组,不包含 end 元素,不改变原数组,如果不传参数,则返回它本身的副本。arr.splice(i, n, item1,...,itemX)从数组中删除从 i 开始的 n 个元素,返回被删除的数组,还可以传入其他的值来替换被删除的数组项目arr.join()将数组变为字符串,以传入的参数连接arr.concat(newArr)连接两个数组,返回值为连接后的新数组arr.reverse()将数组反转,返回值是反转后的数组-
arr.sort()将数组进行排序,返回值是排好的数组。默认将按字母顺序对数组中的元素进行升序。说得更精确点,是按照字符编码的顺序进行排序。如果传入了比较函数:- 如果 compareFunction(a, b) 小于 0 ,那么 a 会被排列到 b 之前
- 如果 compareFunction(a, b) 等于 0 , a 和 b 的相对位置不变
- 如果 compareFunction(a, b) 大于 0 , b 会被排列到 a 之前
- 总结: a-b 是升序,b-a 是降序
arr.forEach((value, index, arr) => { ... })遍历数组, 无 return, 不改变原数组arr.map((value, index, arr) => { ... })遍历数组, 返回一个新数组, 不改变原数组arr.filter((value, index, arr) => { ... })过滤数组,返回一个满足要求的数组arr.every((value, index, arr) => { ... })依据判断条件,数组的元素是否全满足,若满足则返回 ture。全真则真,一假即假arr.some((value, index, arr) => { ... })依据判断条件,数组的元素是否有一个满足,若有一个满足则返回 ture。有真则真,全假才假arr.reduce((prev, next, index, arr) = > { ... }, initValue)为数组中的每一个元素依次执行 callback 函数,并将函数的返回值作为 prev 参数传给下次循环
ES6 新增数组操作
Array.from()将对象转为数组:string,arguments, Set, Map, key 是数字的对象Array.of()用于将一组值,转换为数组。Array.of(3, 11, 8) // [3,11,8]-
arr.copyWithin(target, start, end)将指定位置的成员(从 start 到 end,不包含 end 的成员)复制到其他位置(从 target 开始)(会覆盖原有成员),然后返回当前数组。- target(必需):从该位置开始替换数据。
- start(可选):从该位置开始读取数据,默认为 0。
- end(可选):到该位置前停止读取数据,默认等于数组长度。
[1, 2, 3, 4, 5].copyWithin(0, 3); // [4, 5, 3, 4, 5],用 4,5 把 1,2 替换
[1, 2, 3, 4, 5].copyWithin(0, 3, 4); // [4, 2, 3, 4, 5],用 4 把 1 替换
arr.find((value, index, arr) => { ... })找出第一个符合条件的数组元素,然后返回该元素arr.findIndex((value, index, arr) => { ... })找出第一个符合条件的数组元素,然后返回该元素的位置arr.includes()返回一个布尔值,表示某个数组是否包含给定的值,与字符串的 includes 方法类似arr.entries(),arr.keys()和arr.values()用于遍历数组。keys()是对键名的遍历、values()是对键值的遍历,entries()是对键值对的遍历。-
arr.flat()用于将嵌套的数组“拉平”。默认只会“拉平”一层,如果想要“拉平”多层的嵌套数组,可以给 flat()方法的参数传入一个整数,表示想要拉平的层数。传 infinity 就是不管多少层都打平。[1, 2, [3, 4]].flat(); // [1, 2, 3, 4] [1, 2, [3, [4, 5]]].flat(); //[1, 2, 3, [4, 5]] [1, 2, [3, [4, 5]]].flat(2); //[1, 2, 3, 4, 5] arr.flatMap((value, index, arr) => { ... })先执行 map,然后对返回值组成的新数组执行 flat()方法。
如何判断是否是数组
一般用 1,2 方法
Array.isArray(arr) // es6提供Object.prototype.toString.call(arr) === "[object Array]"arr instanceof Arrayarr.constructor === Array
数组去重
基本数据类型,用 Set
let newArr = [..new Set(arr)];
如果是对象,用 reduce
let temArr = [];
const uniqueList = totalList.reduce((prev, next) => {
  if (!temArr.includes(next.id)) {
    temArr.push(next.id);
    prev.push(next);
  }
  return prev;
}, []);
清空数组
.length等于 0 或者赋值为空数组 []
let a = [1, 2];
a.length = 0;
// 或者
a = [];
复制数组
slice 方法,不传参数
let a = [1, 2];
let b = a.slice();
a === b; // false
数组合并
concat: arr.concat(arr2)
扩展运算符: [...a, ...b]
数组循环中删除元素
删除一个元素后,数组的长度会减小,原来的索引会向前移动。所以一定要给下标重新赋值,减一
for (let i = 0; i < arr.length; i++) {
  if (arr[i] === target) {
    arr.splice(i, 1);
    i = i - 1; // 一定要给下标重新赋值,减一
  }
}
js 运行机制
JavaScript 代码的整个执行过程,分为两个阶段,代码编译阶段与代码执行阶段。
编译阶段
编译阶段会进行:词法分析生成 Tokens,语法分析生成 AST
执行阶段
执行阶段分为两个步骤,创建执行上下文 和 代码执行。
创建执行上下文时,会创建词法环境(let const 类型的变量和函数声明),创建变量环境(var 类型的变量和函数声明),还会决定 this 的指向。
在创建执行上下文的过程中,会进行变量提升,即将 var 变量和函数声明提升到作用域顶部。还会建立作用域链(作用域链是由词法环境和变量环境组成的),确保在代码执行时能够访问正确的变量。
代码执行时会按照执行上下文的作用域链规则执行语句,进行变量赋值,函数调用,以及条件语句执行等。
执行上下文
执行上下文其实就是当代码执行时的 context,包含词法环境,变量环境,以及 this 的指向。共有三种:
- 全局执行上下文
- 函数执行上下文
- eval 执行上下文
伪代码:
GlobalExectionContext = {
  // this value
  ThisBinding: xxxx,
  // 词法环境
  LexicalEnvironment: {
    // ...
  },
  // 变量环境
  VariableEnvironment: {
    //...
  },
};

FunctionExectionContext = {
  // ...
};
词法环境 & 变量环境
一个词法环境由环境记录器和一个可能的引用外部词法环境的引用组成。
- 环境记录器是存储 let const 类型的变量和函数声明等。
- 外部环境的引用意味着它可以访问其父级词法环境。全局环境的外部环境引用是 null。
变量环境:它同样是一个词法环境,只用来存储 var 类型的变量或者函数声明
伪代码
// 全局上下文
GlobalExectionContext = {
  LexicalEnvironment: {
    EnvironmentRecord: {
      Type: "Object",
      // 在这里绑定标识符
    }
    outer: null
  }
}

FunctionExectionContext = {
  LexicalEnvironment: {
    EnvironmentRecord: {
      Type: "Declarative",
      // 在这里绑定标识符
    }
    outer: xxxx // 全局或者外部词法环境的引用
  }
}
作用域 & 作用域链
词法环境和变量环境组成了作用域,在代码执行过程中,会从这些环境中寻找对应的变量,找不到就从父级环境找,形成作用域链。
函数调用栈
栈里面存储的就是函数的调用信息,比如函数本身,函数参数,以及函数的执行上下文。所以我们调试的时候查看不同阶段的 call stack 可以看到当时的参数等信息。
在代码执行阶段,先将全局代码和全局执行上下文放入函数调用栈栈底,然后执行全局代码,如果执行中遇到别的函数,再将局部函数及上下文放入栈。处于栈顶的函数执行完毕之后,就会自动出栈。
变量提升
在执行上下文的创建阶段,会先声明 var 类型的变量,但不进行赋值,执行阶段才去赋值。
所以在后面的代码中可以先使用这个变量,但是他是 undefined
var 变量声明 和 函数声明都会变量提升
- var 变量声明 和 函数声明都会变量提升
- 函数声明是整体提升,优先级高于 var 声明,且直接赋值
- 具体的执行是什么取决于赋值是什么。
var log = function () {
  console.log(1);
};
function log() {
  console.log(2);
}

log(); // 输出 1

// function log 先提升, var log 再提升,function log 会直接给log 赋值。 var log = function 再赋值,所以最后log是consolo.log(1)的
this 指向
简单来说,谁调用这个函数,这个函数中的 this 就指向谁
fn()fn 单独调用,this 指向 windowobj1.obj2.fn();this 指向 obj2var bar = obj.fn; bar();this 指向 window- call()、apply()、bind(),指向新的这个对象
- 箭头函数中 this 指向所在上下文
从原理上来说,在创建可执行上下文的时候,根据代码的执行条件,来判断分别进行默认绑定、隐式绑定、显示绑定等。
var x = 0;
var obj = {
  x: 10,
  bar() {
    var x = 20;
    console.log(this.x);
  },
};

obj.bar(); // 10
var foo = obj.bar;
foo(); // 0
obj.bar.call(window); // 0
obj.bar.call(obj); // 10
foo.call(obj); // 10
v8 执行原理
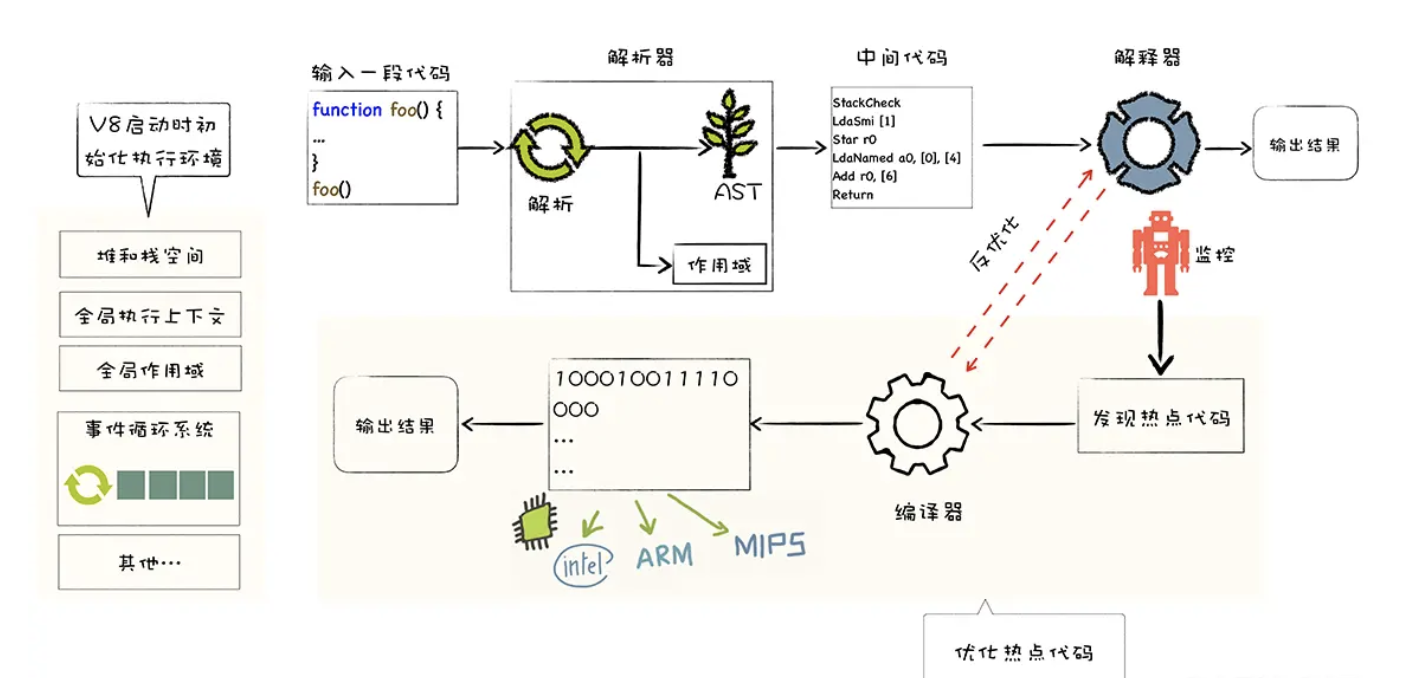
- 初始化堆栈空间,事件循环系统。
- 解析源码,生成 AST 和 全局上下文,全局代码和全局上下文入栈;
- 依据 AST 和作用域生成字节码;
- 解释执行字节码,遇见函数,解析函数,生成 AST 和 函数上下文,函数和其上下文入栈,执行函数。
- 发现热点代码,将其编译为机器码,执行机器码。下次遇见这些代码可以直接执行机器码。
- 反优化生成的机器码。
js 到底是解释型还是编译型语言?
V8 同时采用了解释执行和编译执行这两种方式,这种混合使用的方式称为 JIT (即时编译)。
原型,原型链,构造函数
原型: 即 prototype 属性,只有函数才有,用来存放所有实例对象需要共享的属性和方法。那些不需要共享的属性和方法,就放在构造函数里面。
原型链: 即 __proto__ 属性,任何对象都有这个属性。对象的 __proto__ 指向构造函数的 prototype 属性。
当我们访问一个对象的属性或方法时,如果这个对象内部不存在这个属性,那么他就会去他的 __proto__ 里找这个属性,也就是去父类的 prototype 上找。父类的 prototype 上如果没有,这个 prototype 又会去找他自己的 __proto__,这个 __proto__ 又会有自己的 __proto__,于是就这样 一直找下去,也就是我们平时所说的原型链的概念。
一张图总结:主要是每个部分都要明白__proto__和 constructor 的指向。
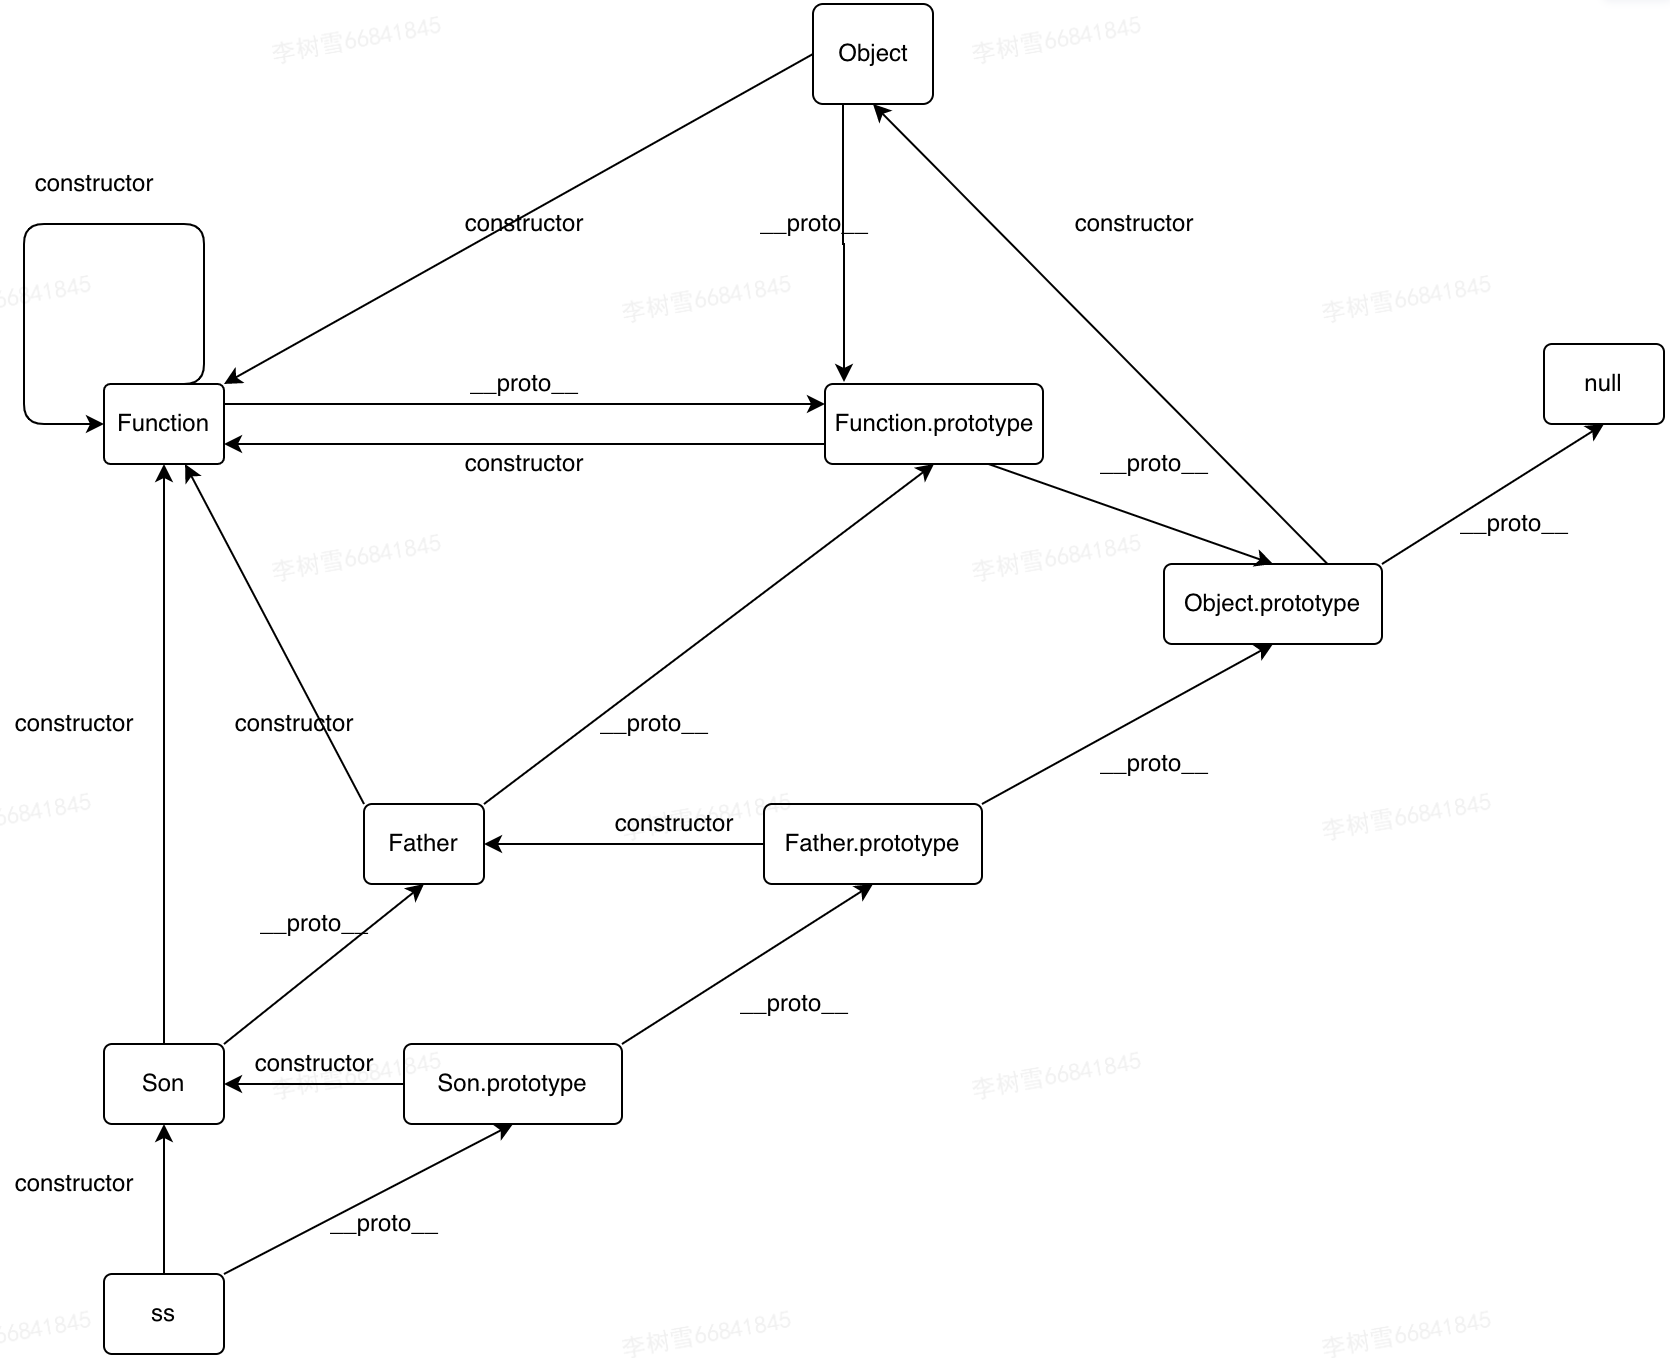
ss.__proto__ === Son.prototype;
Son.prototype.__proto__ === Father.prototype;
Father.prototype.__proto__ === Object.prototype;
Object.prototype.__proto__ === null;
结论:
- 实例的
__proto__属性指向构造函数的 prototype 属性,构造函数的 prototype 的__proto__属性最终指向 Object.prototype,而Object.prototype.__proto__ === null - 构造函数的
__proto__属性指向继承的构造函数,如果没有继承指向 Function.prototype。ES5 中用 function 创建的类,类的__proto__都指向 Function.prototype。
- 实例对象的 .constructor 指向本类
- 类的 prototype.constructor 指向本类
- 类的 .constructor 指向 Function
- 类的 prototype 是父类的原型的复制
5.6 也证明在自己写 ES5 继承的时候, 要些这两行代码。
Son.prototype = Object.create(Father.prototype);
Son.prototype.constructor = Son;
// [].__proto__ === Array.prototype
// Array.prototype.__proto__ = Object.prototype
// Object.prototype__proto__ === null
[].__proto__.__proto__.__proto__ === null;

// ({}).__proto__ = Object.prototype
// Object.prototype__proto__ === null
({}).__proto__.__proto__ === null;
作用域链和原型链,它们的区别
作用域是代码执行时访问变量的,先在自己的作用域寻找,找不到再去父级作用域寻找,形成作用域链。
原型链是代码执行时访问对象的属性或者对象的方法的,先在本身寻找,没有的话就去父类的 prototype 上找。父类原型找不到,再去父类的父类的原型找。形成原型链。
ES5 组合寄生继承
// 组合寄生继承
var Father = function () {
  this.name = "爸爸";
};

var Son = function () {
  Father.call(this);
  this.name = "儿子";
};
Son.prototype = Object.create(Father.prototype);
Son.prototype.constructor = Son;

var ss = new Son();
JS 异步解决方案的发展历程以及优缺点
回调函数
- 回调地狱
- 外层 try catch 捕获不到回调函数内部错误
Promise
优点:解决了回调地狱的问题
缺点:
- 当处于 Pending 状态时,无法得知目前进展到哪一个阶段(刚刚开始还是即将完成)。
- Promise 执行回调的时候,定义 Promise 那部分实际上已经走完了,所以 Promise 的报错堆栈上下文不太友好。
- 无法取消 Promise,一旦新建它就会立即执行,无法中途取消。(实际上没有办法取消 promise 的执行,其他的取消方法,也只是对结果不再处理)
Generator
使用复杂,需要配合 co 库
async/await
优点:
- 同步的写法
- 可以 try catch
- 没有 then 的链式调用
- 错误堆栈信息友好
- 方便调试
缺点:
用 async/await 需要注意的是,如果里面有多个 Promise,需要注意他们是否有依赖,没有依赖的话用 await Promise.all([…])
闭包
一个函数包含另一个函数,并且被包含的函数使用了父函数中的变量。内部函数即为闭包。即有权访问另一个函数作用域内变量的函数都是闭包。
内部函数总是可以访问其所在的外部函数中声明的参数和变量,即使在其外部函数被返回(寿命终结)了之后。
闭包的作用:
- 让函数内部的变量一直保存在内存中
- 实现私有变量
立即执行函数(IIFE)
立即执行函数是指在定义后立即执行的 JavaScript 函数。IIFE 是一种特殊的函数表达式,通常使用匿名函数的形式定义,然后在定义后紧跟一对括号 (),用于立即执行该函数。
作用:
- 创建一个独立的作用域。这个作用域里面的变量,外面访问不到(即避免「变量污染」)
- 如果需要访问这里面的方法,可以挂载在 window 上,或者 return 给外面。以此模拟模块。
(function (j) {
  console.log(j);
})(3);

var module = (function (j) {
  console.log(j);
  // 模拟模块
  return {
    test: "这是模块",
  };
})(3);
前端模块化的发展历程
-
IIFE
立即执行函数定义模块
-
CommonJS
Nodejs 的模块规范, 用 module.exports 定义当前模块对外输出的接口(不推荐直接用 exports),用 require 加载模块。
-
AMD
require.js 遵循了这个规范。通过 define 方法去定义模块,通过 require 方法去加载模块。
-
CMD
seajs 遵循了这个规范。通过 define 方法去定义模块,通过 seajs.use 去加载模块。
-
ES6 module
ES6 的模块规范
-
UMD
UMD 是同时支持 AMD 和 CommonJS 的规范,也会将模块定义为一个全局变量。
(function (root, factory) {
  if (typeof define === "function" && define.amd) {
    // 如果有define函数,并且define函数具备amd属性,则可以判断当前环境满足AMD规范
    define(["test"], factory());
  } else if (
    typeof exports === "object" &&
    typeof module.exports === "object"
  ) {
    // 是commonjs模块规范,nodejs环境
    module.exports = factory();
  } else {
    // 浏览器全局变量(root 即 window)
    root.umdModule = factory();
  }
})(this, function () {
  return {
    name: "我是一个umd模块",
  };
});
AMD 和 CMD 的区别
- 对于依赖的模块,AMD 是提前加载,CMD 是延迟加载。
- 从规范上,CMD 更贴近 CommonJS 的异步模块化方案
ES6 模块和 CommonJS 模块的区别
- ES6 模块输出的是引用。CommonJS 模块输出的是一个值的拷贝。
- ES6 模块是在编译时就被确定,CommonJS 模块是运行时才确定。
- ES6 模块可以导出多个。CommonJs 是单个值导出。
- ES6 模块导入只能写在顶层。CommonJs 导入可以写在任何地方。
CommonJS 值拷贝发生在给 module.exports 赋值的那一刻,例如:
let val = 1;
module.exports = {
  val,
};
与 CommonJS 不同,ESM 中 import 的不是对象, export 的也不是对象。import 模块中引入的值就指向了 export 中导出的值。是引用。
ESM 之所以被称为 编译时确定,是因为它的模块解析是发生在 编译阶段。也就是说,import 和 export 这些关键字是在编译阶段就做了模块解析,这些关键字的使用如果不符合语法规范,在编译阶段就会抛出语法错误。
与此对应的 CommonJS,它的模块解析发生在 执行阶段,因为 require 和 module 本质上就是个函数和对象,只有在 执行阶段 运行时,这些函数或者对象才会被执行并确定。因此被称为 运行时确定。
module.exports 和 exports 的区别
- exports 是 module.exports 的引用, 即
var exports = module.exports = {}。 - 初始时这两个变量是指向同一个空对象
- 最终导出的是 module.exports,即 require 方能看到的只有 module.exports 这个对象,它是看不到 exports 对象的
- 分不清楚就用 module.exports
module.exports = { ... }; // 正确
exports = { ... }; // 错误
exports.a = { ... }; // 正确
设计模式
- 工厂:工厂起到的作用就是隐藏了创建实例的复杂度,只需要提供一个接口,简单清晰。
- 单例:保证每次访问得到的都是同一个对象,可以用全局对象存储。
- 适配器:为了解决两个接口不兼容的情况,通过包装一层实现两个接口正常协作。
- 装饰模式:不需要改变已有的接口,作用是给对象添加功能。
- 代理模式:代理是为了控制对对象的访问,不让外部直接访问到对象。代理类可以访问并操作对象,然后暴露相关方法供外部调用。
- 发布订阅(观察者)模式:当对象发生改变时,订阅方都会收到通知。先定义一个对象,这个对象包含 on, off 方法和 trigger 方法,以及一个存储回调函数的 map。on 的时候往 map 里面 push,trigger 的时候再从 map 中拿出来并执行, off 的时候删除。